ChatGPT va filigraner ses textes dans l’UE : ce qui change pour vous
OpenAI va filigraner les textes de ChatGPT dans l’UE. Qui peut détecter ce marquage, sa fiabilité selon l’éditeur, ses limites et ce que demande l’AI Act.
Sommaire
- Qu’annonce OpenAI le 5 octobre 2026 ?
- Qui est concerné : ChatGPT, Codex, l’API et les outils de rédaction
- Peut-on détecter un texte écrit avec ChatGPT ?
- Ce qu’un filigrane ne prouve pas
- Images, vidéos et sons : C2PA, openai.com/verify et SynthID Detector
- Pourquoi seulement l’UE : l’article 50 de l’AI Act
- Que faire si vous publiez des textes écrits avec l’IA ?
- Questions fréquentes
OpenAI a annoncé le 5 octobre 2026 qu’un filigrane invisible serait ajouté, « au cours des prochaines semaines », aux textes de ChatGPT et de Codex dans l’Union européenne. Il concernera les utilisateurs éligibles de toutes les formules, dans l’UE seulement. Au 7 octobre, aucune date de mise en service n’est fixée et aucun outil public ne permet de vérifier un texte : le détecteur est réservé, sur candidature, à des chercheurs et à des organismes experts (annonce d’OpenAI, lue le 07/10/2026).
Qu’annonce OpenAI le 5 octobre 2026 ?
Le filigrane d’OpenAI s’appelle textGrain. Quand le modèle hésite entre plusieurs mots possibles, une clé secrète oriente légèrement ce tirage ; sur un passage assez long, ces choix forment un motif statistique qu’un détecteur muni de la même clé peut rechercher. Selon OpenAI, le procédé n’ajoute ni mention visible, ni caractères cachés, ni espaces invisibles, ni ponctuation inhabituelle (centre d’aide d’OpenAI, consulté le 07/10/2026).
Trois mesures, trois calendriers :
| Mesure | Pour qui | Situation au 7 octobre 2026 |
|---|---|---|
| Filigrane invisible sur les textes de ChatGPT et de Codex | Utilisateurs éligibles de toutes les formules, dans l’UE uniquement | Annoncé « au cours des prochaines semaines » |
| Filigrane en option dans l’API | Clients de l’API du monde entier, pour certains modèles | Disponible depuis le 5 octobre, désactivé par défaut |
| Détecteur de filigrane pour les textes | Chercheurs et organismes experts agréés, au cas par cas | Candidatures ouvertes ; pas d’outil public |
Sources : annonce d’OpenAI du 05/10/2026 et centre d’aide d’OpenAI, consultés le 07/10/2026.
Le rapport technique sur textGrain (PDF en anglais, 05/10/2026) décrit la méthode sans résultats chiffrés ; l’annonce affirme que textGrain a fait jeu égal ou mieux que d’autres méthodes, dont SynthID pour le texte de Google, sans renvoyer à aucune évaluation indépendante.
Qui est concerné : ChatGPT, Codex, l’API et les outils de rédaction
ChatGPT et Codex dans l’UE. OpenAI ne détaille pas les critères d’éligibilité. Hors de l’UE, ChatGPT ne marquera pas ses textes au lancement. Formules et usages de l’assistant : fiche ChatGPT.
L’API, en option dans le monde entier. Depuis le 5 octobre, tout client de l’API peut activer le filigrane pour certains modèles ; l’option est désactivée par défaut. Elle se règle pour toute l’organisation (Organization settings → Data controls → Text provenance) ou par projet (Project Settings → Text provenance), modèle par modèle. Activer l’option ne donne pas accès au détecteur (centre d’aide, consulté le 07/10/2026).
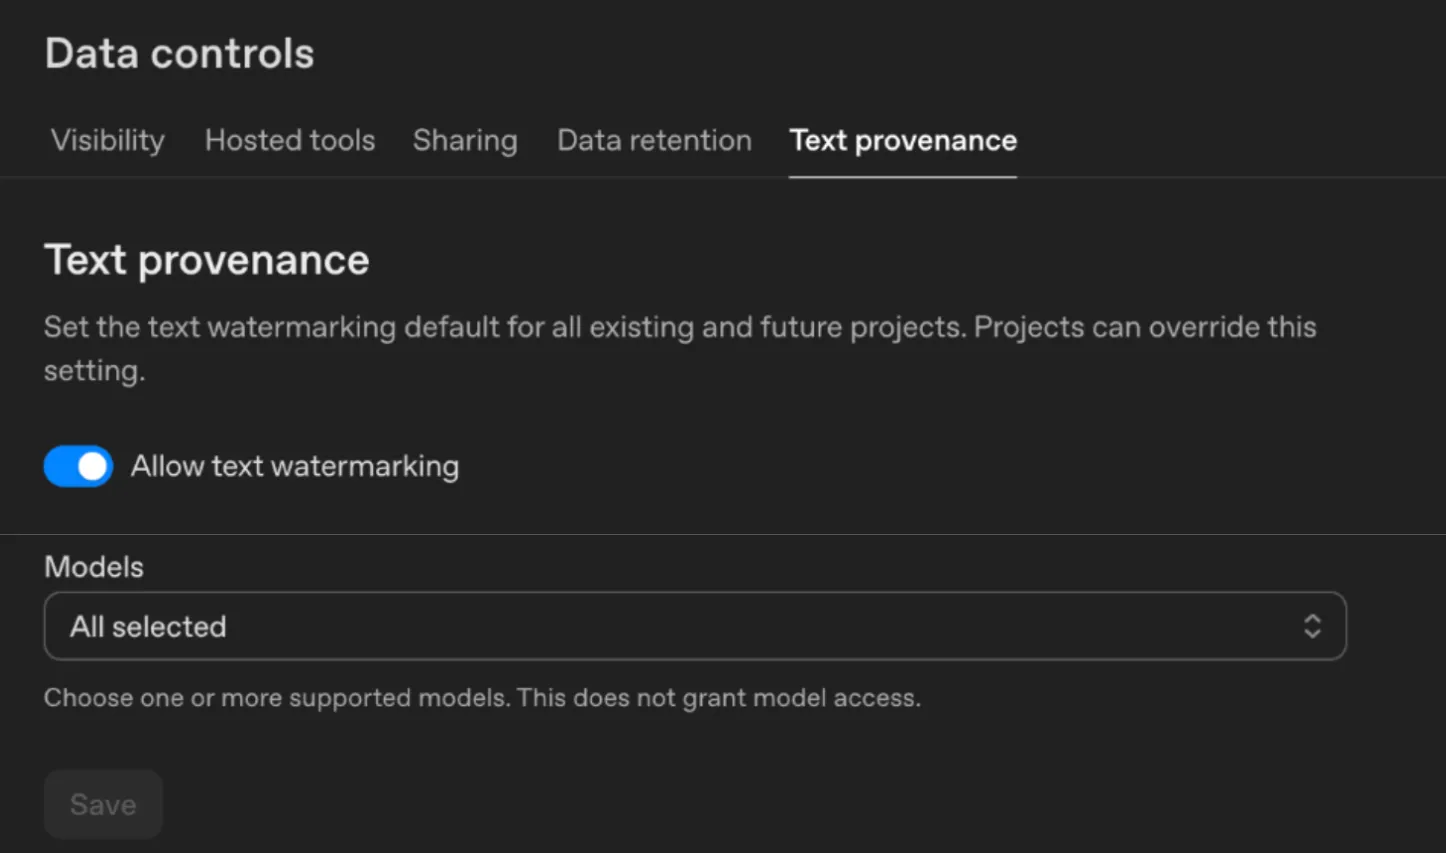
Illustration publiée par OpenAI dans son centre d’aide, consultée le 07/10/2026 : le réglage de l’organisation, que chaque projet peut remplacer, montré activé.
Les outils de rédaction construits sur l’API. Un service qui appelle un modèle d’OpenAI par l’API ne produit un texte filigrané que si son éditeur a activé l’option, pour un modèle compatible ; OpenAI dit laisser ses clients décider de la place du filigrane dans leurs propres obligations de transparence. Koala propose des modèles d’OpenAI (GPT-6 Luna et GPT-6 Sol) à côté de modèles d’Anthropic et de Google (page des modèles de Koala, vérifiée le 07/10/2026), mais n’a rien publié sur le filigrane : son choix est non communiqué. Writesonic ne dit ni quels modèles alimentent son rédacteur d’articles ni ce qu’il fait du filigrane (page d’accueil et page tarifs consultées le 07/10/2026).
Peut-on détecter un texte écrit avec ChatGPT ?
Pas avec un outil public. Au 7 octobre 2026, ni un enseignant, ni un employeur, ni un moteur de recherche n’a accès au détecteur d’OpenAI. L’éditeur examine au cas par cas les candidatures de chercheurs et d’organismes experts, et justifie cette restriction par le risque de filigranes manqués et de faux positifs.
Pour le texte libre, le code de bonnes pratiques européen sur la transparence des contenus générés par l’IA, dont OpenAI est signataire, autorise à réserver la détection, pour une durée limitée, à des utilisateurs experts vérifiés : autorités, médias, vérificateurs de faits, chercheurs, organismes d’enseignement et de recherche (code publié le 10/06/2026 ; code et liste des signataires consultés le 07/10/2026). Quant aux détecteurs d’IA d’autres sociétés, ils analysent le style d’un texte après coup, sans la clé, et ne lisent donc pas ce filigrane, rappelle OpenAI.
La longueur et le type de texte comptent
Les mesures publiées par OpenAI reposent sur un taux de faux positifs visé de 1 %. Calcul : sur 1 000 textes sans filigrane, cet objectif correspond à environ 10 signalements erronés.
| Longueur du passage | Questions de psychologie | Questions de mathématiques |
|---|---|---|
| 200 tokens | 78,5 % | 36,5 % |
| 300 tokens | 89,7 % | 52,0 % |
| 400 tokens | 94,3 % | 60,8 % |
Taux de détection de textes filigranés, réponses à des questions du jeu de données ELI5, pour 1 % de faux positifs visé. Graphique de l’annonce d’OpenAI du 05/10/2026, consulté le 07/10/2026. Données de l’éditeur, pas un essai du site.
Un token est un mot ou un morceau de mot. Le texte court ou contraint se détecte moins bien : en mathématiques, la formulation laisse moins de choix au modèle ; le centre d’aide cite aussi le code, les réponses très factuelles et les textes recopiés sans changement. Le code de bonnes pratiques n’exige pas de filigrane sous 200 tokens, soit environ 150 mots en anglais selon OpenAI, qui ne donne pas d’équivalence pour le français.
Les retouches réduisent la détection
| Longueur du passage | Texte non retouché | 10 % des mots remplacés | 25 % des mots remplacés |
|---|---|---|---|
| 200 tokens | 66,3 % | 37,8 % | 7,0 % |
| 300 tokens | 84,8 % | 56,3 % | 11,6 % |
| 400 tokens | 92,0 % | 65,8 % | 17,2 % |
Taux de détection pour 1 % de faux positifs visé, sur un même ensemble de 600 réponses filigranées en anglais (questions ELI5), dont une partie des mots a été remplacée par des synonymes. Graphique publié par OpenAI le 05/10/2026, consulté le 07/10/2026. Données de l’éditeur, pas un essai du site.
Les deux tableaux ne portent pas sur le même échantillon, ce qui explique sans doute l’écart à 200 tokens entre 78,5 % et 66,3 % pour des textes non retouchés. Le centre d’aide ajoute qu’une reformulation importante ou une traduction peut rendre le filigrane indétectable. Conséquence pratique : un résultat négatif ne prouve presque rien.
La détection varie selon la langue
Dans les 24 langues officielles de l’UE (500 consignes traduites de l’anglais, 1 % de faux positifs), l’espagnol obtient le meilleur taux (69,0 %) et le roumain le plus bas (42,2 %, avant le renforcement du signal appliqué par OpenAI aux langues sous 60 %). Le français n’en a pas eu besoin : il se situe autour de 62 %, une lecture du graphique, la valeur n’étant pas publiée en chiffres (centre d’aide, consulté le 07/10/2026).
Ce qu’un filigrane ne prouve pas
OpenAI liste lui-même les limites d’un résultat de détection :
- la part humaine : le filigrane peut indiquer qu’un système d’OpenAI a produit ou retravaillé une partie du passage, pas la part du travail humain ;
- l’auteur et la responsabilité : il ne dit pas à qui appartient le texte, si son usage était légal, si une mention était obligatoire ni qui en répond ;
- l’utilisateur : il ne rattache le texte à aucune personne, organisation, compte, consigne ou conversation ;
- l’exactitude : il ne dit pas si le passage est vrai, trompeur ou cité dans le bon contexte ;
- l’origine humaine : son absence ne prouve pas qu’un humain a écrit le texte, qui peut être trop court, retouché ou traduit, venir d’un modèle non pris en charge, être antérieur au filigrane ou provenir d’un autre éditeur.
Pour un enseignant ou un employeur, ni la présence ni l’absence de filigrane ne suffit donc à établir qui a écrit un texte.
Images, vidéos et sons : C2PA, openai.com/verify et SynthID Detector
Pour les images et l’audio, la vérification est déjà publique, mais pas pour le texte. Les images prises en charge créées avec ChatGPT, Codex ou l’API portent des métadonnées C2PA et un filigrane SynthID, l’audio un filigrane SynthID, et openai.com/verify recherche ces signaux dans un fichier image ou audio (consulté le 07/10/2026). Le 7 octobre 2026, Google a ouvert à tous, en anglais, SynthID Detector, qui vérifie si une image, une vidéo ou un fichier audio a été créé avec l’IA de Google ou de ses partenaires, dont OpenAI (billet de Google, consulté le 07/10/2026). L’outil se présente comme un lecteur de filigranes, pas comme un détecteur d’IA général.
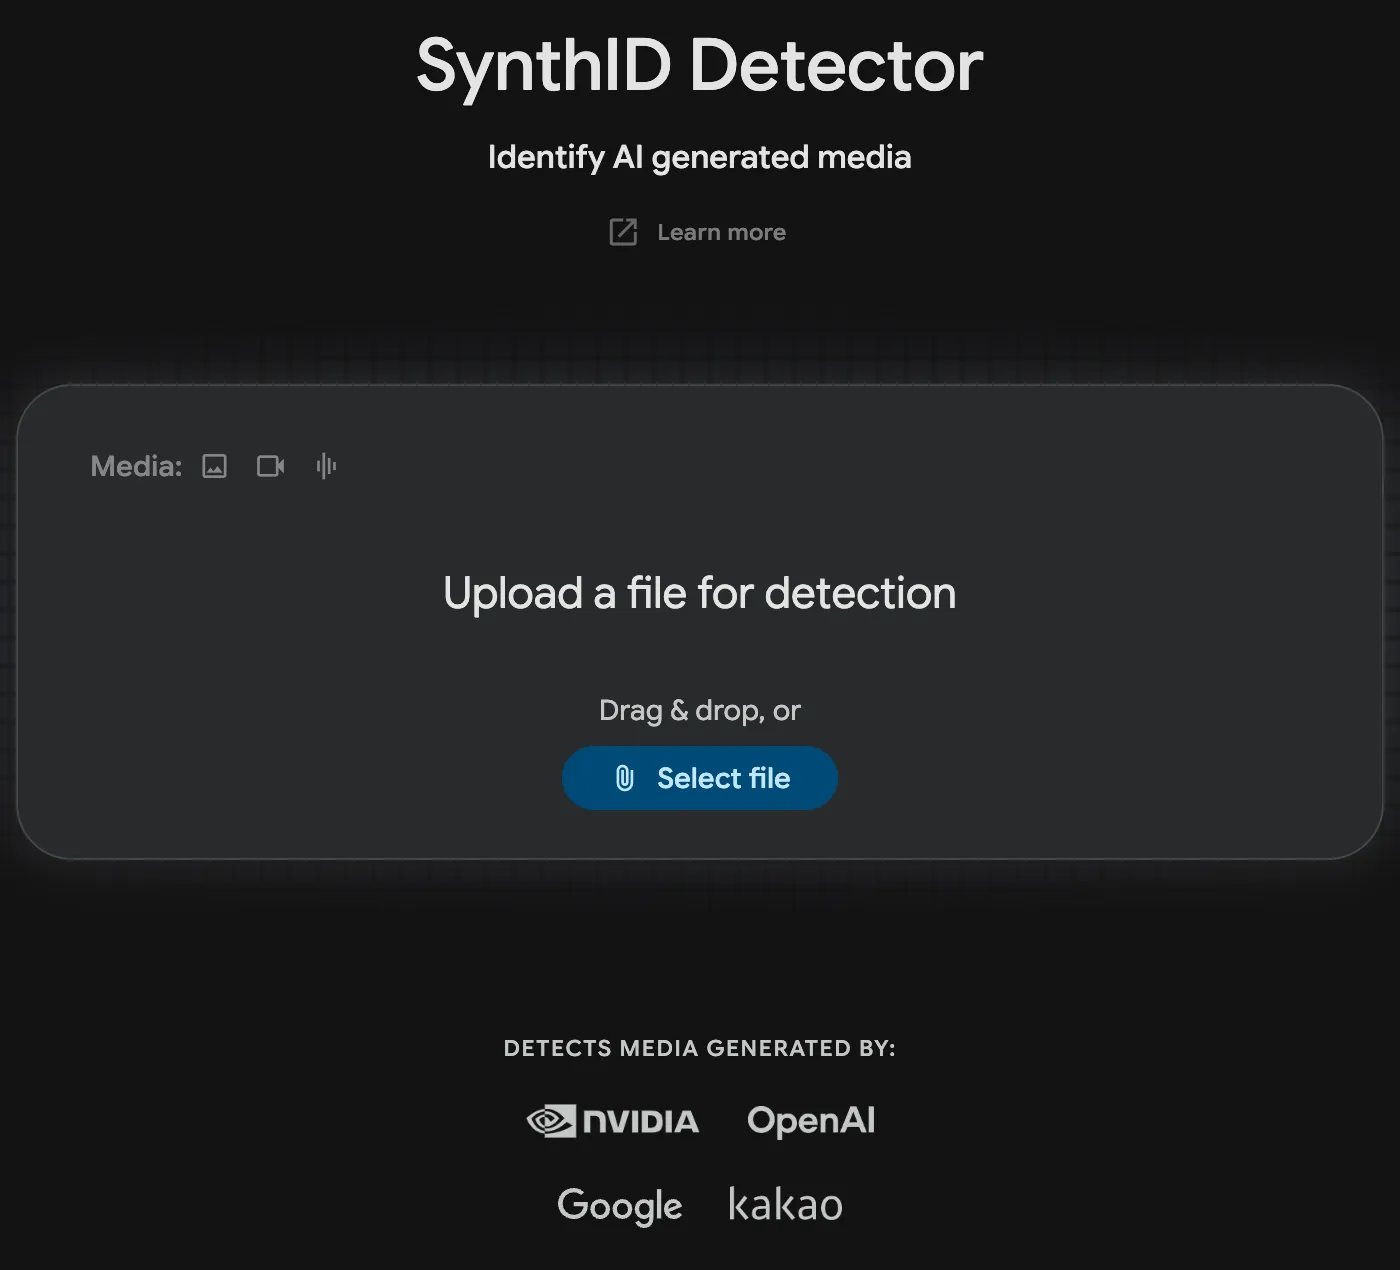
Page publique de SynthID Detector, boîte des conditions d’utilisation masquée pour la capture (07/10/2026) : trois entrées, image, vidéo et son, aucune pour le texte.
Pourquoi seulement l’UE : l’article 50 de l’AI Act
L’article 50, paragraphe 2, de l’AI Act impose aux fournisseurs de systèmes d’IA qui génèrent du son, des images, de la vidéo ou du texte de marquer leurs sorties dans un format lisible par machine et détectable, sauf simple assistance à la mise en forme standard ou modification non substantielle des données fournies par l’utilisateur professionnel (le « déployeur »). Les règles de transparence s’appliquent depuis le 2 août 2026 (article 113), mais l’article 111, paragraphe 4, laisse aux IA génératives mises sur le marché avant cette date jusqu’au 2 décembre 2026 pour se conformer au marquage (dates vérifiées le 07/10/2026 dans la version consolidée d’EUR-Lex et sur la fiche de la Commission). À s’en tenir au texte, c’est donc cette échéance qui concerne ChatGPT ; OpenAI n’y relie pas explicitement son calendrier.
OpenAI ne fait pas du filigrane un réglage mondial par défaut : une approche régionale doit lui permettre d’apprendre de l’usage réel avant d’aller plus loin. Anthropic fait un autre choix et annonce un filigrane sur les textes de ses futurs modèles Claude, appliqué dans le monde entier dès son lancement, faute de moyen durable, pour l’instant, de le limiter à une région (explication d’Anthropic, 14/08/2026, mise à jour le 01/09/2026, consultée le 07/10/2026). Calendrier complet de l’AI Act : dossier sur la réglementation de l’IA.
Que faire si vous publiez des textes écrits avec l’IA ?
Le filigrane est une obligation des fournisseurs : il ne remplace pas les mentions visibles qui peuvent s’imposer à ceux qui publient, rappelle le centre d’aide d’OpenAI.
| Votre situation | Ce que change le filigrane | Ce qui reste à vérifier |
|---|---|---|
| Étudiant qui utilise ChatGPT | Rien de visible ; aucun outil public ne lit ce filigrane | Les règles de votre établissement sur l’IA et la déclaration qu’il demande |
| Rédacteur, blog, média | Les textes produits dans ChatGPT par les utilisateurs éligibles de l’UE seront marqués après le déploiement | Mentionner l’IA pour un texte d’intérêt public, sauf relecture humaine avec responsabilité éditoriale assumée (article 50, paragraphe 4) |
| Entreprise qui utilise l’API ou un outil de rédaction | Rien par défaut dans l’API d’OpenAI ; pour un outil tiers, cela dépend de son éditeur | Activer ou non l’option, et vérifier vos obligations de fournisseur ou de déployeur avec un juriste |
Une simple correction orthographique ou grammaticale ne compte pas comme relecture, précise la FAQ de la Commission sur l’article 50 (mise à jour le 24/07/2026, consultée le 07/10/2026). Pour garder la main sur un texte rédigé avec ChatGPT, voir le guide rédiger du contenu de qualité avec ChatGPT. L’UE propose aussi des icônes facultatives pour étiqueter un contenu généré par l’IA.
Ces repères décrivent les textes officiels au 07/10/2026. Ce n’est pas un conseil juridique : pour un cas précis, consultez un juriste ou le service d’assistance de la Commission sur l’AI Act.
Questions fréquentes
Mes textes ChatGPT sont-ils déjà filigranés ?
Aucun outil public ne permet de le vérifier au 07/10/2026. L’annonce d’OpenAI prévoit un déploiement dans l’UE « au cours des prochaines semaines », sans date, alors que la version anglaise de son centre d’aide, mise à jour le 6 octobre 2026, dit au présent que les textes de ChatGPT dans l’UE portent ce signal.
Un professeur peut-il détecter un texte écrit avec ChatGPT grâce à ce filigrane ?
Pas aujourd’hui : le détecteur d’OpenAI n’est ouvert, sur candidature, qu’à des chercheurs et organismes experts. Même avec un accès, un résultat ne dit ni qui a écrit le texte ni quelle part revient à l’humain.
Le filigrane modifie-t-il le texte ou ajoute-t-il des caractères cachés ?
Il n’ajoute aucun caractère, espace ou signe visible selon OpenAI : il oriente le choix entre des mots plausibles. L’éditeur dit ne pas mesurer de baisse de qualité ; c’est sa propre évaluation.
Les textes produits avec Koala ou Writesonic seront-ils filigranés ?
Pas par le filigrane d’OpenAI, sauf choix de leur éditeur : un texte généré avec un modèle d’OpenAI via l’API n’est marqué que si le service active l’option. Koala propose aussi des modèles d’autres éditeurs, qui suivent leurs propres règles. Au 07/10/2026, Koala et Writesonic n’ont rien communiqué sur le filigrane.
SynthID Detector peut-il vérifier un texte ?
Non. L’outil de Google, ouvert à tous le 07/10/2026, analyse les images, les vidéos et les fichiers audio. openai.com/verify se limite aussi aux images et à l’audio.
Le filigrane permet-il de m’identifier ?
Non, selon OpenAI : il ne rattache le texte à aucune personne, aucun compte, aucune consigne ni aucune conversation. Il indique seulement qu’un modèle d’OpenAI a probablement produit ou retravaillé le passage.